Chercher, trouver, et beaucoup perdre
septembre 19th, 2026 Posted in Non classéDepuis cet été, lorsque l’on effectue une recherche avec Google, notamment si celle-ci a la forme d’une question, la réponse est produite par l’IA Gemini.
Google, très clairement, cherche à réagir à la disparition annoncée des moteurs de recherche, que le public délaisse au profit des IAs génératives1. Et c’est une tendance compréhensible : quand on veut une réponse à une question précise, le résultat fourni par les IAs actuelles peut être étonnamment concret et efficace, comme ici avec Google :
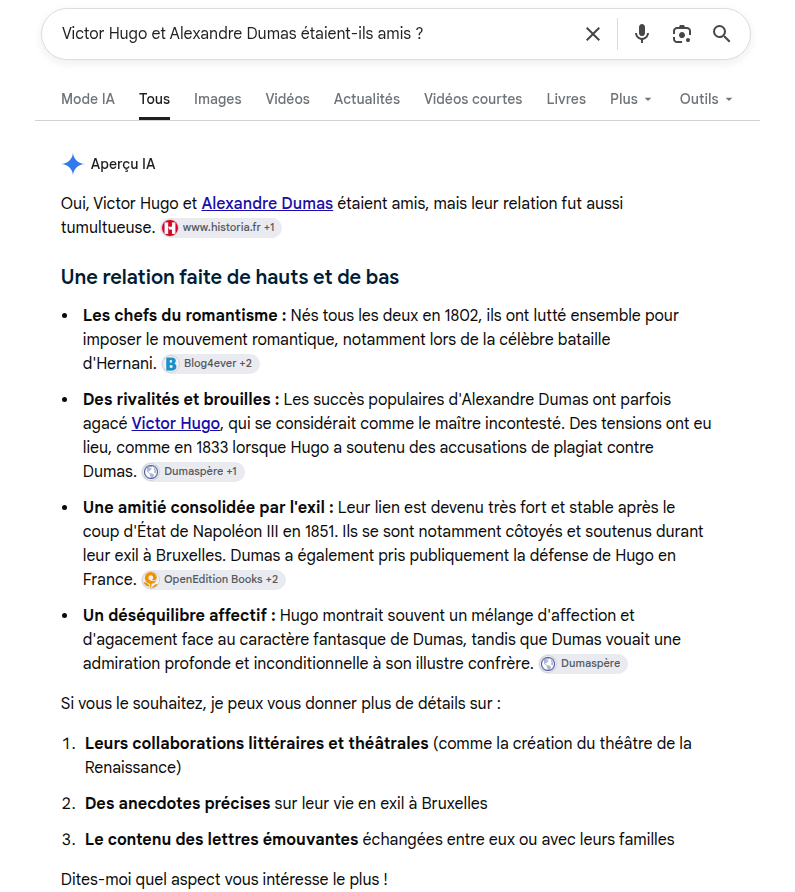
Je suis conscient que c’est la définition même du biais de confirmation.
Chaque affirmation est associée à des liens qui permettent, d’un clic, de savoir qui l’a émise et donc d’en évaluer la justesse. Et la synthèse proposée est suivie d’ouvertures quant aux questions annexes que l’on pourrait se poser : « Si vous le souhaitez, je peux effectuer une recherche approfondie sur… ». Parfois, c’est exactement la question qu’on aurait eue en tête, et c’en est presque vexant, comme lorsque Gmail nous propose de répondre « super, merci ! » à un e-mail alors que nous nous apprêtions à écrire « super, merci ! » : soit cela signifie que Google connaît par cœur nos automatismes et c’est inquiétant, soit cela veut dire que nous sommes parfaitement banals, soit les deux.
Parfois, Gemini propose des réponses extraordinairement à côté de la plaque, voire absurdes. Ainsi, alors que je cherchais une publicité des années 1980, Google/Gemini m’a affirmé avec aplomb qu’il avait existé une campagne de la RATP dont le slogan était : « les rames ne se cachent plus pour mourir », suivi d’un cours non-sollicité sur la fin du ticket de transport en carton. Ce genre d’hallucination est me semble-t-il assez rare, quoique plus gênante que les réponses « à côté de la plaque » telles que le Google traditionnel en fait2.
Comme toujours face à un nouveau service numérique, je commence par me demander non pas si je suis d’accord ou non, mais quel effet il produit sur moi. Et dans le cas qui nous occupe, c’est affreux à admettre mais je m’habitue bien au « mode IA » de Google, je suis forcé en tout cas de constater que les réponses suffisent souvent et me font effectivement gagner du temps. Sans compter tous les cas où la puissance d’une machine capable de lire des kilomètres de texte en quelques secondes est précieuse : qui veut lire l’intégralité du code civil ou de la Bible pour retrouver tel point de droit, telle histoire dont on a un vague souvenir ?
Une autre partie de moi est opposée à ce système, pour plus d’une raison.
La question écologique
Bien entendu il y a les questions géopolitiques et écologiques liées à l’IA générative — mais laissons de côté ce point qui concerne l’IA en général, et surtout, qui a toujours concerné Google, car même dans son mode « traditionnel », le moteur de recherches consomme une quantité extravagante de ressources. Pour une unique requête, pas moins d’un millier de serveurs sont sollicités en même temps3, qui fournissent chacun une partie de la réponse et les annonces qui vont avec, avant d’agréger l’ensemble à la volée ; d’autres serveurs se chargent d’analyser et de stocker les requêtes et des informations sur les requérants ; et enfin, en amont, les robots de Google travaillent jour et nuit à lire le web, à l’indexer, à le stocker en cache, et à dupliquer toutes ces données pour qu’elles se trouvent au plus proche de ceux qui en auront besoin au moment où ils en auront besoin. Bref, la question des ressources est une question critique, mais n’est certainement pas une question neuve dans le cas de Google, et j’ai peur qu’il en aille de même avec les moteurs de recherche « écoresponsables », qui certes investissent une part de leurs revenus dans des projets environnementaux… mais recourent à Google ou Bing pour produire les réponses aux requêtes qu’on leur fait et donc, consomment encore plus.
La version « IA » de Google est sans doute4 plus dispendieuse encore, puisqu’on doit ajouter à tout ça l’entraînement initial du modèle (des milliers d’ordinateurs analysant des textes pendant des mois, la production de réponses rédigées et la consultation en temps de sites web. Je note néanmoins que les réponses de Gemini semblent être conservées, car à deux questions quasi-identiques on obtient des réponses parfois totalement identiques, et cela constitue a priori une économie de ressources. Par ailleurs, Google ne semble pas beaucoup utiliser le contexte de ses interactions avec des utilisateurs, le passif des requêtes (dont on suppose pourtant qu’elle sont conservées quelque part) n’est pas pris en compte5.
La question du pillage
C’est souvent difficile à expliquer mais je ne fais pas grand cas du « pillage » effectué pour l’entraînement des LLMs, car ce grief me semble reposer sur un malentendu : l’entraînement des LLMs consiste à analyser des milliards de textes, non pour en voler directement les informations ou le style, mais pour déterminer la probabilité statistique que tel mot suive tel autre dans un contexte donné6. Et à ma connaissance, l’entraînement de base ne produit qu’un modèle mathématique, les textes, eux, n’y sont pas stockés. Pour un tel entraînement, il faut disposer de textes bien écrits. Wikipédia est une source pour ce genre de choses, mais aussi les livres de cuisine ou de développement personnel, la grande littérature ou les articles de presse. Certes, la forme et le fond sont liés et peut-être qu’un LLM de base pourrait en quelque sorte réécrire sans le « savoir » et donc sans citer sa source un article de presse existant, ou (et ça, ça a été démontré par l’expérimentation) qu’une IA générative visuelle peut, en suivant un prompt ultra-précis qui l’y amène, refaire une image un peu comme dans la nouvelle de Borges où Pierre Ménard réécrit de fond en comble des chapitres du Don Quichotte de Cervantès, en y ajoutant l’influence d’auteurs plus récents mais en aboutissant pourtant à l’exact même texte7.
par Balthasar Frederic Loizel
Ce ne sera pas une idée très populaire chez certains mais pour moi, l’entraînement des LLMs8 ne relève pas plus du vol de propriété intellectuelle que l’entraînement au langage des bébés, qui écoutent parler les gens autour d’eux et structurent leur manière de parler et de penser en fonction de cet apprentissage9. Pour aller plus loin, je dirais que cette question de l’entraînement est même toute la beauté du principe même des LLMs, qui réussissent de manière brillante ce qu’une version plus sémantique de l’IA tente depuis soixante-dix ans10.
Mais on va le voir plus loin, dans le cas spécifique de Google, le vol, la plagiat, le parasitisme ou la concurrence déloyale, sont une réalité.
Les moteurs de recherche
Les trois questions qui me préoccupent immédiatement, qui sont intimement liées, sont celle de l’avenir même des moteurs de recherche, celle de l’avenir du web, et celle du préjudice subi par les créateurs de contenu, notamment les journalistes.
Je n’ai pas connu Internet avant le web11, mais je peux me vanter d’avoir plus ou moins vu naître les moteurs de recherche pour le web : Yahoo (alimenté à la main !), Lycos, et surtout Altavista qui semblait si supérieur à tous les autres. Et puis Google est arrivé, et a tout changé. Son système, plutôt simple sur le papier, qui consiste à évaluer la pertinence d’un site à l’aune du nombre des autres sites qui le mentionnent, a immédiatement montré sa puissance : le premier lien proposé était généralement le bon — je me souviens qu’on comparait l’efficacité d’Altavista et celle de Google sur le mot « White House » : avec Google, le site officiel de la Maison-Blanche arrivait en tête tandis qu’il fallait écumer des pages et des pages d’Altavista pour aboutir au bon lien. Bien sûr, ce principe était éminemment « hackable », et pour voir leur site bien placés, des gens — nous tous qui avions des contenus à diffuser en ligne — ont mis au point des astuces diverses : mots-clés cachés dans les pages (écrits en blanc sur fond blanc pour n’être lus que par le moteur de recherches), « fermes » de sites pointant les uns vers les autres, etc.
Google a répondu en complexifiant son algorithme et en imposant de facto un ensemble de « bonnes pratiques » aux webmestres. Et il ne s’est pas agi ici que de l’intérêt du public : si le logiciel Flash a été tué, c’est d’abord parce qu’il ne s’intégrait pas au business-model d’Apple (il aurait pu permettre de produire des applis hors de son écosystème) mais surtout parce qu’il pouvait nuire à la régie publicitaire Google Ads, et que pour cette raison, Google a sciemment défavorisé le référencement des sites réalisés avec Flash. Don’t be evil, qu’ils disaient. Quoi qu’il en soit, Google est vite devenu, et resté, le principal moteur de recherche dans le monde (neuf requêtes sur dix), et ses deux principaux concurrents, Bing et Baidu, en sont directement inspirés. Et nous, usagers, avons appris à nous entendre avec Google. À savoir par avance ce que nous pouvons lui demander et comment, à nous repérer rapidement dans la première page de réponse,…
Mais voilà, arrivés à la fin de l’an IV de ChatGPT, la popularité des moteurs de recherche « traditionnels » faiblit, car cela fait longtemps que ce que l’on demande à un moteur de recherche ce n’est pas forcément l’adresse d’un site web, mais bien souvent la réponse à une question. Les sites web proposés par un moteur de recherche ne sont souvent qu’une étape vers la réponse à une interrogation telle que « comment savoir si j’ai un orteil cassé ? » ou « à qui demander le formulaire 276R ? » ; etc. Et pour cet usage, des IAs telles que ChatGPT ou Claude fournissent des réponses plus immédiates puisqu’elles sont désormais capables d’effectuer des recherches sur Internet et de synthétiser les documents qu’elles trouvent.
Nous économisons un clic. Bien. Mais cela a un prix.
La fin du web
Avec ses réponses, Gemini retourne totalement la vocation initiale des moteurs de recherche. Le lien vers un site web n’est plus ce qui est fourni comme résultat à une requête, ce n’est plus le but, c’est ce qui est produit comme justification, comme caution pour une somme d’affirmations péremptoires, presque une manière de se défausser. Une minuscule icône nous informe que si Gemini est si sûr de lui, c’est qu’il a lu un truc sur un site gouvernemental ou dans un magazine. Et nous ne cliquons même pas pour vérifier s’il a bien lu, bien compris l’article qui est censé légitimer ses affirmations, le lien est cliquable, certes, mais il est là pour nous dispenser de lire, exactement comme le font les mentions du genre « TVA non applicable conformément à l’article… ».
En bref, le web devient le carburant de Google/Gemini, qui perd son rôle de guide, n’est plus là pour nous orienter mais au contraire pour nous dissuader d’aller plus loin. L’explorateur qui guidait les voyageurs s’est transformé en garde-champêtre.
Pour un blogueur comme moi, c’est dommage. Si vous n’êtes pas en train de lire ce texte, c’est que Google l’a lu pour vous, en a tiré ce qu’il voulait, et ne vous a pas demandé d’aller vous renseigner plus avant. Si vous êtes en train de le lire, c’est en faisant partie d’un groupe qui rabougrit à vue d’œil. Je ne connais pas les statistiques de fréquentation de mes sites mais les derniers chiffres généraux que j’ai vu passer montraient une véritable chute de la fréquentation des sites web. Pour un blog amateur comme le mien, ce n’est pas très grave, parfois je n’écris que pour moi-même, pour me relire dans quelques années. Mais pour les sites de presse en ligne, dont le modèle économique est fort précaire et dépend directement de la fréquentation, c’est potentiellement tragique.
Bien entendu, l’évolution de Google n’est que le dernier clou du cercueil du web, la dernière trahison, car les réseaux sociaux ont déjà énormément œuvré à capter le public du web et son contenu. Et dans le cas spécifique de Google, la création de Google News avait été un coup dur pour les médias d’information, aboutissant à des procès, des accords, des taxes, et c’est peut-être ce qui se produira en réponse à la fonction IA de Google.
Et il y a pire
Plusieurs enquêtes internationales ont mis à jour l’extraordinaire activité des réseaux de propagande poutinophile sur Internet : des milliers d’articles, chaque jour, sont publiés sur des sites divers, non seulement pour distiller un discours enthousiaste saluant la « troisième grande guerre patriotique » (après la guerre contre Napoléon et celle contre Hitler) que mène Vladimir Poutine en Ukraine, mais aussi et surtout pour déstabiliser les pays occidentaux au moindre prétexte en y attisant des conflits sociétaux et communautaires. Antisémitisme, identité de genre, bien sûr, mais aussi les crises ponctuelles comme l’affaire des migrants marocains de Ceuta, qui aurait suscité au moins 23 000 articles publiés en quelques jours par un réseau de sites web fantômes. Des sites web fantômes, au sens où la plupart n’a strictement aucun lecteur. Cette énergie n’est pourtant pas dépensée en vain, car ce n’est pas vous ou moi que les services de désinformation russes veulent convaincre : c’est ChatGPT, Claude, Gemini et Grok.
Notons que si les géants de l’IA nous préparent une Apocalypse, ce n’est pas celle dont ils se vantent actuellement : l’appel qu’ils se lancent à eux-mêmes de freiner le développement d’une IA qui deviendrait incontrôlable est plus un argument de vente (« notre technologie est dangereuse, financez-nous et ce sera vous le danger ») dans une période financière critique (avec des entrées en bourse qui peuvent potentiellement faire éclater la bulle IA) qu’autre chose.
C’est pour tout le reste qu’ils sont dangereux : écologie, emploi et libertés publiques.
Je ne doute pas que pendant les prochaines élections, nous passerons un temps considérable à demander à tous ces services si telle ou telle affirmation émanant de tel ou tel candidat est fondée, ou à nous renseigner auprès d’eux sur la position de tel ou tel parti sur tel ou tel sujet. Il est bien possible que les réponses seront largement infléchies par les manipulations que j’évoque ci-avant, pour lesquelles la masse fera loi : que vaut un unique article du Guardian, fruit de semaines ou de mois d’enquête, parfois prudemment ignoré par ses confrères, face à des milliers de sites qui servent à rendre les faits et leur interprétation illisibles, ou à les forger purement et simplement ? Rappelons que la Russie, pays qui pratique sur notre sol des actions hostiles (sabotages, cyberattaques) et a montré sa capacité à faire de l’ingérence politique dans tous les pays d’Europe soutient (ou tient ?) financièrement le premier parti d’extrême-droite français. Le pouvoir russe utilise ses réseaux « Pravda » et « Rybar » pour influencer les IAs étasuniennes, qui sont quant à elles détenues par des sociétés souvent favorables au même bord politique. Au secours.
Avec l’Agentic AI (en français « IA agentique », mais « IA agissante » eût pu être plus clair), ce n’est pas seulement d’articles que nous allons être submergés, c’est aussi d’interactions factices : « likes », commentaires et interlocuteurs mécaniques qui nous donneront l’impression d’être entourés de milliers de personnes différentes qui expriment toutes les nuances possibles d’opinions que nous ne partageons pas. L’Humain étant un animal social, attentif à l’opinion générale et affecté par le sentiment qu’il en a, un tel effet de foule qui peut convaincre celui qui a peur de rester seul ou en tout cas démoraliser, démotiver, celui qui croit l’être.
Que faire ?
Dès que Google a déployé son « aperçu IA », les utilisateurs se sont vus proposer quelques aménagements pour contourner cet outil, comme l’utilisation d’extensions dédiées ou le fait d’ajouter -noIA aux requêtes. Ces tactiques permettent de continuer à utiliser Google à l’ancienne, mais, sauf à être massivement employées, ne changent rien au problème de fond, qui est un pourrissement total du web, dont les contenus sont amenés à n’être plus produits et lus que par des machines, quand ils ne sont pas des pièges déguisés en sites officiels ou en sites de téléchargement pour escroquer les étourdis.
Entre les casques et les épées, ça devait faire un bruit de casserole, non ?
Je suis nostalgique de l’époque des « home-pages », quand le web français était peuplé de quelques dizaines de milliers de chercheurs (surtout) qui utilisaient un espace privé de leur labo pour partager leur passion pour la philatélie ou que sais-je. Ce n’est pas le web, mais je suis nostalgique de Usenet, ce système unifié de forums qui permettait aux amateurs de ci ou ça de se regrouper à un même endroit. Je suis nostalgique de l’époque où chaque fournisseur d’accès offrait à ses abonnés quelques méga-octets d’espace pour héberger une « page perso », comme on disait. Je me souviens de Mygale.org, installé un étage au dessus de ma salle à l’Université Paris 8 et créé par un étudiant en maîtrise. Je suis nostalgique des blogs, bien sûr, même de ceux que je regardais avec dédain, les Skyblogs, Overblogs et autres, tellement laids, mais où tout un chacun pouvait faire vivre ce qui l’animait et rencontrer ses semblables. Je suis nostalgique de l’époque où Internet était un espace de partage relativement libre et ouvert, avant que des machines de guerre tel Facebook n’en figent les modalités d’interaction, à leur profit exclusif.
Je ne sais pas si le web d’antan reviendra, ou plutôt, je ne sais pas si nos prochaines « zones d’autonomie temporaire » se trouveront sur Internet. Je ne sais pas si Internet peut être sauvé. J’aimerais beaucoup que cela se puisse, car j’ai profondément aimé Internet.
À mon petit niveau, voilà ce que je vais faire : je vais continuer à poster des contenus personnels, avec mes idées, ma voix, sur ce blog bien sûr mais aussi ailleurs, en commentaire à d’autres blogs, par exemple. Et mes articles se finiront en queue de poisson si j’en ai envie, ou dérivant subitement sans prévenir. Et ils seront beaucoup trop longs, ils n’auront pas l’efficacité moyenne d’un post de chatGPT. Et je publierai des images hors-sujet si j’en ai envie, pour que les gens se demandent pourquoi je les ai mises là où je les ai mises. Et je m’efforcerai d’aller lire les contenus eux aussi personnels publiés par d’autres et qui portent leurs idées, avec leur voix, leur fantaisie, leur poésie, leurs lubies. Je tenterai d’être curieux, de m’intéresser aux sujets dont je n’ai jamais entendu parler. Et j’achèterais des livres faits par de vrais gens, pour de vrais gens, et des fanzines agrafés à la main. Et j’irai me promener, souvent. Je fais déjà tout ça, bien sûr, mais à présent j’aurai une raison : tenter de sauver quelque chose, même si je ne sais pas exactement quoi.
- Notons que si Google a pu sembler en retard sur OpenAI et Anthropic, c’est un groupe de chercheurs de chez Google qui a lancé la course aux Large Language Models avec le papier Attention is all you need, en 2017. [↩]
- Par exemple lorsqu’on cherche l’affiche d’un film un peu obscur et que Google Images nous noie sous les images d’un produit électroménager homonyme. [↩]
- Source : Gemini [↩]
- Il est éminemment difficile de comparer avec précision les impacts écologiques comparés des différents systèmes, que l’on parle de moteurs de recherche, de LLMs ou de services de streaming : les différentes sociétés concernées mènent elles-mêmes des programmes de recherche pour tenter d’y voir clair. Les comparaisons en heures d’éclairage avec une ampoule 100W ou un litre d’eau frappent les esprits mais sont généralement absurdes. Je me contente donc ici de faire des déductions en partant du peu que je sais.
Un fait intéressant à connaître : beaucoup de constructions de centres de données ne répondent pas à un besoin actuel mais font le pari d’une fuite en avant effrénée… [↩] - Contrairement à ChatGPT, qui peut savoir avec trois mots que ce dont je lui parle fait écho à des questions abordées trois mois plus tôt. [↩]
- Certaines personnes se rassurent au sujet des LLMs en se disant qu’ils ne « pensent » pas, que ce sont des machines qui ne savent rien faire de plus que de régurgiter un contenu statistique. Ce n’est plus vrai. Afin d’éviter d’être mis en échec par des questions arithmétiques ou logiques où répondre par une probabilité est absurde (« combien fait douze fois trois moins six », « quelle est la couleur du cheval blanc d’Henri IV »), les outils tels que chatGPT sont bien plus que des LLMs, ils sont visiblement connectés à des modules de calcul, d’inférence logique, ils sont équipés de « verrous » qui permettent d’esquiver des réponses philosophiquement ou pénalement problématiques, ils répondent selon un « persona » déterminé, dans un contexte, en connexion avec l’ensemble du web… Il est évident que ce sont des machines n’éprouvent pas d’envie et ne disposent pas de conscience (quoique ça veuille dire), mais leurs réponses ont parfois de quoi nous troubler. Enfin c’est le cas des chatBots « littéraires ». Les chatBots vocaux, qui sont concentrés sur la réactivité, sont plus faciles à ridiculiser. [↩]
- On trouve la nouvelle Pierre Ménard, auteur du Quichotte dans le recueil Fictions. Notons qu’il existe un écrivain actuel du nom de Pierre Ménard : c’est un pseudonyme en hommage au personnage de Borges. [↩]
- Et je ne parle vraiment que de l’entraînement initial, qui sert à produire le modèle vectoriel. À l’usage ensuite, les chatBots peuvent tout à fait aller piller des contenus ici ou là et les paraphraser. [↩]
- Je pense subitement à l’horrible expérience menée par l’empereur du Saint-Empire Frédéric II de Hohenstaufen, au XIIIe siècle, qui, voulant découvrir le langage originel de l’Humanité (Adam parlait-ils grec, latin, hébreu ?…) avait demandé qu’on élève des nourrissons orphelins sans leur parler. Les bébés seraient tous morts assez rapidement, ce qui pour les psychologues qui ont relayé ce récit, prouve surtout que les interactions sont indispensables aux nouveaux-nés. [↩]
- Soixante-dix ans si on date la naissance de l’IA en 1956. Je remonterai bien plus loin pour ma part, avec au moins deux millénaires et demi de tradition philosophique ou linguistique pour comprendre (et donc à terme automatiser) les règles de la logique et du langage. [↩]
- J’ai connu le web alors qu’il avait encore des concurrents — Gopher, WAIS et Archie. J’ai aussi connu l’époque où on pouvait acheter des livres contenant les liens les plus intéressants d’Internet, etc. [↩]
8 Responses to “Chercher, trouver, et beaucoup perdre”
By deesnay on Sep 19, 2026
Excellent article, merci !
Moi aussi, je fais partie des dinosaures du web, ceux qui continuent à partager obstinément et patiemment leur passion, en créant des contenus à l’ancienne, en dehors des réseaux sociaux, à l’abri du tumulte des flux instantanés qu’on peut scroller jusqu’à l’infini.
Des contenus que plus personne ne lit.
By J.-N. on Sep 19, 2026
@deesnay autrefois j’utilisais les outils de statistiques de Google pour savoir si j’avais des lecteurs. Et puis ils ont changé un truc, j’ai rien compris, j’ai abandonné. À présent mon seul indice ce sont les « likes » et les partages sur les réseaux sociaux (mais va savoir s’ils correspondent à des lectures ou si ce sont juste des gestes amicaux un peu paresseux comme j’en fais moi-même), et les commentaires… Malheureusement trop rares, puisqu’entre l’obligation de modérer et la captation de la conversation par les réseaux sociaux, l’habitude s’est perdue.
By Iznogoud on Sep 19, 2026
Vous oubliez un gros problème des LLM : ce n’est pas seulement qu’elles lisent les pages web telles que wikipedia, les sites d’info ou perso, c’est qu’elles le font massivement et en permanence.
De sorte qu’il devient aujourd’hui impossible d’héberger un site soi-même (alors qu’avec la fibre et un petit NAS, c’est assez simple) et que les coûts d’hébergement explosent parce que les LLM utilisent une énorme bande passante.
By J.-N. on Sep 19, 2026
@Iznogoud C’est vrai, mais là aussi c’est déjà ce que faisait Google avant que les LLMs déboulent. Je ne suis pas spécialiste mais je crois que l’explosion du coût de l’hébergement est moins liée à la bande passante (quoique cela doive jouer bien sûr) qu’au besoin (avéré ou anticipé) de puissance de calcul, qui fait monter le prix du matériel, crée des tensions diverses depuis les questions de consommation d’électricité à celles sur les terrains d’implantation des centres de données en passant par la question des ressources en minerais et de la géopolitique des processeurs (Chine, Taïwan, US).
L’hébergement de mes sites commence à représenter une somme conséquente, ce qui n’a pas toujours été le cas, je constate bien ce problème, qui effectivement nuit à l’idée de publications personnelles et libres.
By da_norf on Sep 19, 2026
J’ai lu, en entier. Je me suis questionné sur le choix des images d’illustration. Je suis resté un peu sur ma faim quant à la fin de l’article. Maintenant je vais sortir me promener et faire des courses.
By J.-N. on Sep 19, 2026
@da_norf : c’est exactement la bonne attitude ;-)
By Hélène Khodoss on Sep 21, 2026
J’ai lu jusqu’au bout, et je vais relire et partager.
Pour l’ultra-non spécialiste que je suis, c’est l’article sur l’IA le plus intéressant que j’aie lu depuis que nous sommes submergés d’articles et de livres sur l’IA.
By J.-N. on Sep 21, 2026
@Hélène C’est très contrariant, ce déluge de choses à lire sur l’IA, je suis sûr qu’il y a plein de textes intéressants mais je n’arrive que rarement à me motiver pour les lire, et puis il y a tellement de propos redondants que tous les discours (IAphobes ou IA–o–dules) deviennent très lassants.
C’est drôle, il y a pile dix ans j’ai sorti (avec l’excellente Marion Montaigne) une bande dessinée sur l’Intelligence Artificielle, et je cherche mollement où j’ai pu en garder un exemplaire chez moi — enfin un exemplaire en français ; à portée de vue j’ai les versions turque, chinoise, coréenne et allemande (je suis très fier d’avoir été traduit dans tous ces pays) —, car je me demande à quel point ça a vieilli : c’était avant chatGPT, avant les LLMs, d’ailleurs, et même avant la victoire d’AlphaGo contre Lee Sedol (à une semaine près je crois). Donc à des années lumière de l’IA d’aujourd’hui. Mais on s’y moquait déjà du discours des « doomers » (notamment d’Elon Musk) qui investissent dans l’IA tout en disant que l’IA doit être stoppée avant de devenir consciente et de prendre le pouvoir sur la planète.
Enfin même si ce livre a sans doute beaucoup vieilli, ce qui était bien à sa sortie c’est qu’on était un peu tout seuls à parler du sujet ! Quand le même éditeur nous a proposé d’en faire une version un peu augmentée, on n’a pas trop rebondi : à quoi servirait un tel livre maintenant que le Parisien parle d’IA tous les jours ?